Forward Deployed AI Engineer
산업 현장의 문제를 직접 정의하고, 그 해법을 SECA의 Core Product로 만듭니다.
- 인턴 · 정규직
- 서울 서초 · NAVER D2SF 강남
- 유연근무
SECA는 이런 팀입니다
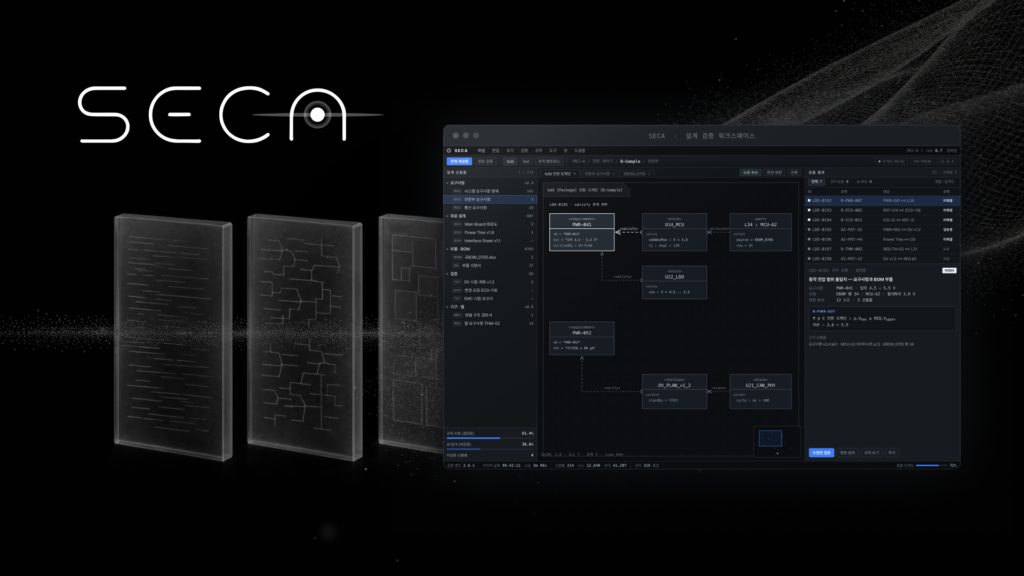
SECA는 LG전자 사내벤처에서 스핀오프한 딥테크 스타트업입니다. 실제 산업 현장의 H/W 설계 데이터를 바탕으로, 엔지니어의 설계 리드타임을 줄이는 AI Agent를 개발합니다. 공동창업자와 핵심 연구진은 서울대·KAIST·연세대·고려대 학·석사 출신 AI Researcher입니다.
국내외 제조 대기업의 실제 설계 조직과 실증 과제를 진행하면서 Ontology, Knowledge Graph, AI Agent, Multimodal Document Intelligence, LLM Evaluation을 연구하고 제품으로 만듭니다.
- 함께하는 곳
- LG전자 자동차·가전사업부, 현대자동차, DB글로벌칩, BOS반도체, 한국전력공사, HL Robotics
- 연구 환경
- NVIDIA Inception과 AWS Global Startup 프로그램의 지원으로 GPU와 다양한 모델을 자유롭게 써 볼 수 있습니다.
- 글로벌
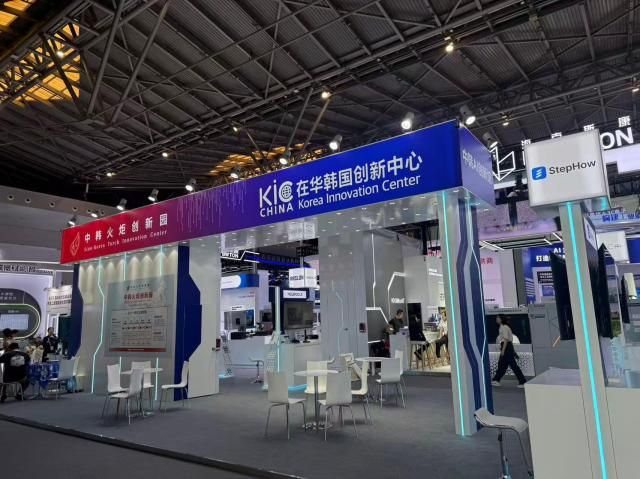
- 국내외 산업·AI 전시회에 꾸준히 참가하고 있으며, 베트남, 중국, 유럽, 미국 텍사스 오스틴으로 확장을 준비하고 있습니다.
하는 일
어느 트랙이든 고객사의 실제 문제를 풉니다. 현장에서 시작해 제품으로 끝납니다.
01
제조 AI 프로젝트
- 국내외 제조 대기업의 실제 설계 조직과 함께 일합니다.
- 현업 엔지니어의 문제를 듣고, AI가 풀 수 있는 문제로 구조화합니다.
- 프로젝트 안에서 하나의 문제를 맡아 데이터 분석, 모델·파이프라인 설계, 실험, 평가, 개선까지 직접 수행합니다.
- 고객 프로젝트에서 반복되는 문제를 추상화해 SECA의 공통 모듈과 제품으로 발전시킵니다.
02
AI Research
- 논문을 읽는 데서 끝내지 않고, 실제 산업 데이터에서 성능을 검증합니다.
- EDA × AI 연구를 진행하며, DAC, ICCAD, MLCAD, ISEDA, TCAD와 탑티어 AI 학회를 목표로 연구실과 공동 연구도 합니다.
03
AI Product Engineering
- 모델 출력이 실제 설계 업무에 쓰일 수 있도록 근거 연결, 구조화 출력, 검증 로직, Evaluation Pipeline을 구현합니다.
- 고객 과제에서 검증한 기능을 일회성 코드로 남기지 않고 제품 모듈로 만듭니다.
이런 분을 찾습니다
- AI에 의존해 코드를 쌓기보다, 아키텍처와 데이터 흐름을 직접 설계할 수 있는 분
- 논문이나 새로운 방법론을 읽고 빠르게 구현해 비교 실험할 수 있는 분
- AI가 생성한 코드를 그대로 쓰지 않고, 문제에 맞는 구조와 품질을 직접 검증해 완성도를 높일 수 있는 분
- 처음 접하는 산업과 문서를 빠르게 이해하고 문제를 구조화할 수 있는 분
- 결과가 안 나올 때 새로운 프레임워크로 갈아타기보다 원인을 깊게 파고드는 분
우대
- AI 서비스를 실제 고객 환경까지 배포·운영해 본 경험
- Docker, Kubernetes, AWS/EKS, On-Premise 환경 배포 경험
트랙
Ontology · Knowledge Graph · RAG
흩어진 설계 지식을 Ontology와 Knowledge Graph로 구조화하고, 그 위에서 근거를 정확히 찾아오는 RAG를 만듭니다.
이 트랙에서 하는 일
- 요구사항, 부품, 설계 블록 사이의 관계를 표현하는 Ontology와 Knowledge Graph 스키마를 설계합니다.
- 구조화된 설계 데이터 위에서 Retrieval, Reranking, Graph RAG 파이프라인을 구현합니다. 의미 검색, 속성 필터, 수치·범위 조건을 어디에 쓸지 직접 정합니다.
- 답변과 제안마다 원문 근거를 연결하고, 검색과 생성의 품질을 나눠서 측정하는 평가셋과 Evaluation Pipeline을 만듭니다.
- 고객 데이터에서 검색이 실패하는 원인을 추적하고, 반복되는 처리를 공통 스키마와 모듈로 남깁니다.
이런 강점이 있으면 잘 맞습니다
- Ontology나 Knowledge Graph를 직접 설계하고 실제 데이터로 채워 본 분
- RAG를 데모에서 끝내지 않고, 지표를 세워 Retrieval과 Reranking 품질을 끌어올려 본 분
- 검색 결과가 틀렸을 때 데이터, 인덱싱, 쿼리, 생성 중 어디가 원인인지 가려낼 수 있는 분
우대
- Graph RAG 구현 경험
- Dataset 또는 LLM Evaluation Benchmark 구축 경험
- Embedding, Reranker 모델 Fine-tuning 경험
Multimodal Document Parsing
Datasheet, 도면, 회로도, 표처럼 사람이 보라고 만든 엔지니어링 문서를 AI가 이해할 수 있는 데이터로 바꿉니다.
이 트랙에서 하는 일
- Requirements, Datasheet, Drawing, Schematic, BOM에서 텍스트, 표, 도형, 기호를 추출해 구조화합니다.
- 표, 다이어그램, 회로도처럼 배치가 곧 의미인 문서를 VLM, OCR, Layout 분석을 조합해 파싱합니다.
- 추출한 값마다 단위, 조건, 원문 위치를 함께 남겨 이후 검색과 검증에서 근거로 쓸 수 있게 합니다.
- 문서 유형별 실패 사례로 평가셋을 만들고, 모델이나 파이프라인을 바꿀 때마다 전후를 비교합니다.
이런 강점이 있으면 잘 맞습니다
- Multimodal Document, Table, Diagram Understanding을 실제 문서로 깊게 다뤄본 분
- OCR과 VLM 출력의 오류 패턴을 분석하고, 후처리와 검증 로직으로 품질을 끌어올려 본 분
- 스캔본, 다단 표, 도면처럼 정형화되지 않은 입력을 끝까지 붙잡고 처리해 본 분
우대
- 모델 Fine-tuning, Inference Optimization 경험
- Document AI용 Dataset 또는 Benchmark 구축 경험
- CAD 도면, 회로도 등 엔지니어링 문서 처리 경험
Design Automation Agent
회로와 Block Diagram을 읽고 이해한 위에서, 엔지니어의 설계 업무를 자동화하는 Agent 플로우를 설계합니다.
이 트랙에서 하는 일
- 회로도, Block Diagram, RTL, BOM을 읽고, 엔지니어의 설계·검토 업무를 단계로 나눠 Agent 플로우로 옮깁니다.
- 요구사항에서 Block Diagram 초안과 부품 후보를 만들고, 설계 오류와 누락을 근거와 함께 찾아내는 Agent를 구현합니다.
- Tool 호출, 구조화 출력, 검증 로직을 여러 단계로 엮되, 어느 단계에서 실패했는지 재현하고 분석할 수 있게 만듭니다.
- 현업 엔지니어와 직접 이야기하며 무엇을 자동화하고 어디서 사람이 확인해야 하는지 정합니다.
이런 강점이 있으면 잘 맞습니다
- 회로나 Block Diagram을 읽고 설계 의도를 이해할 수 있는 분
- LLM Agent, Multi-Agent, MCP로 실제 업무 플로우를 자동화해 본 분
- Agent가 그럴듯한 오답을 낼 때, 검증 단계를 설계해 걸러낼 수 있는 분
우대
- 회로·반도체·EDA·제조 도메인 실무 또는 연구 경험
- EDA × AI 연구 경험 (DAC, ICCAD, MLCAD 등)
- RTL, 검증(Assertion, Testbench) 관련 경험
근무 조건
- 고용 형태
- 인턴 또는 정규직 (인턴은 학기 중 파트타임 협의 가능)
- 근무지
- 서울 서초구 · NAVER D2SF 강남
- 근무 방식
- 유연근무
- 모집 인원
- 0명
- 처우
- 경력과 역량에 따라 협의
- 개발 환경
- Claude Code, Codex 등 최신 AI Coding Tool과 GPU 서버 지원
채용 과정
01
서류 검토
02
Coffee chat
03
Project & Tech Interview
1주일 프로젝트는 작은 범위의 실제 문제를 직접 풀어보는 과정입니다.
정답보다 문제를 이해하고, 가설을 세우고, 실험하며 결과를 검증하는 과정을 봅니다.
지원 방법
- 이메일
- info@secalabs.com
- 메일 제목
- [SECA 지원] 이름
- 이력서
- 직접 기여한 대표 프로젝트 또는 작성한 논문 설명 — 가장 깊게 파본 문제 하나를 보여주세요.
- GitHub 또는 LinkedIn 링크
무엇을 만들었는지보다 어떤 문제가 있었고, 무엇이 실패했고, 원인을 어떻게 찾았으며, 실제로 무엇을 개선했는지를 보고 싶습니다.